Wan AI (Wan IA): guía del generador de vídeo open source de Alibaba
Todo sobre el generador de vídeo Wan AI (Wan IA): arquitectura, benchmarks, instalación local, API en la nube, precios y cómo se compara con Sora, Kling y Runway.

El generador de vídeo Wan AI es un modelo open source de texto a vídeo e imagen a vídeo desarrollado por Tongyi Lab, de Alibaba. Publicado con licencia Apache 2.0, supera de forma constante a sus competidores de código cerrado en el benchmark VBench —con un 86,22 % de puntuación global frente al 84,28 % de Sora— y sigue siendo totalmente gratuito para uso comercial. Tanto si quieres ejecutar Wan en local con una sola GPU como si prefieres acceder al modelo completo de 14.000 millones de parámetros mediante una API en la nube, esta guía lo cubre todo, desde la arquitectura hasta los precios, para que empieces hoy mismo a generar vídeo cinematográfico con IA.
¿Qué es el generador de vídeo Wan AI?
El generador de vídeo Wan AI es una familia de modelos open source de generación de vídeo creada por Tongyi Laboratory, de Alibaba. A diferencia de alternativas cerradas como Sora de OpenAI o Veo de Google, toda la suite de modelos Wan —pesos, código de entrenamiento y scripts de inferencia— está disponible públicamente bajo licencia Apache 2.0. Eso significa que cualquiera puede descargar, modificar, hacer fine-tuning y desplegar Wan en proyectos comerciales sin pagar royalties.
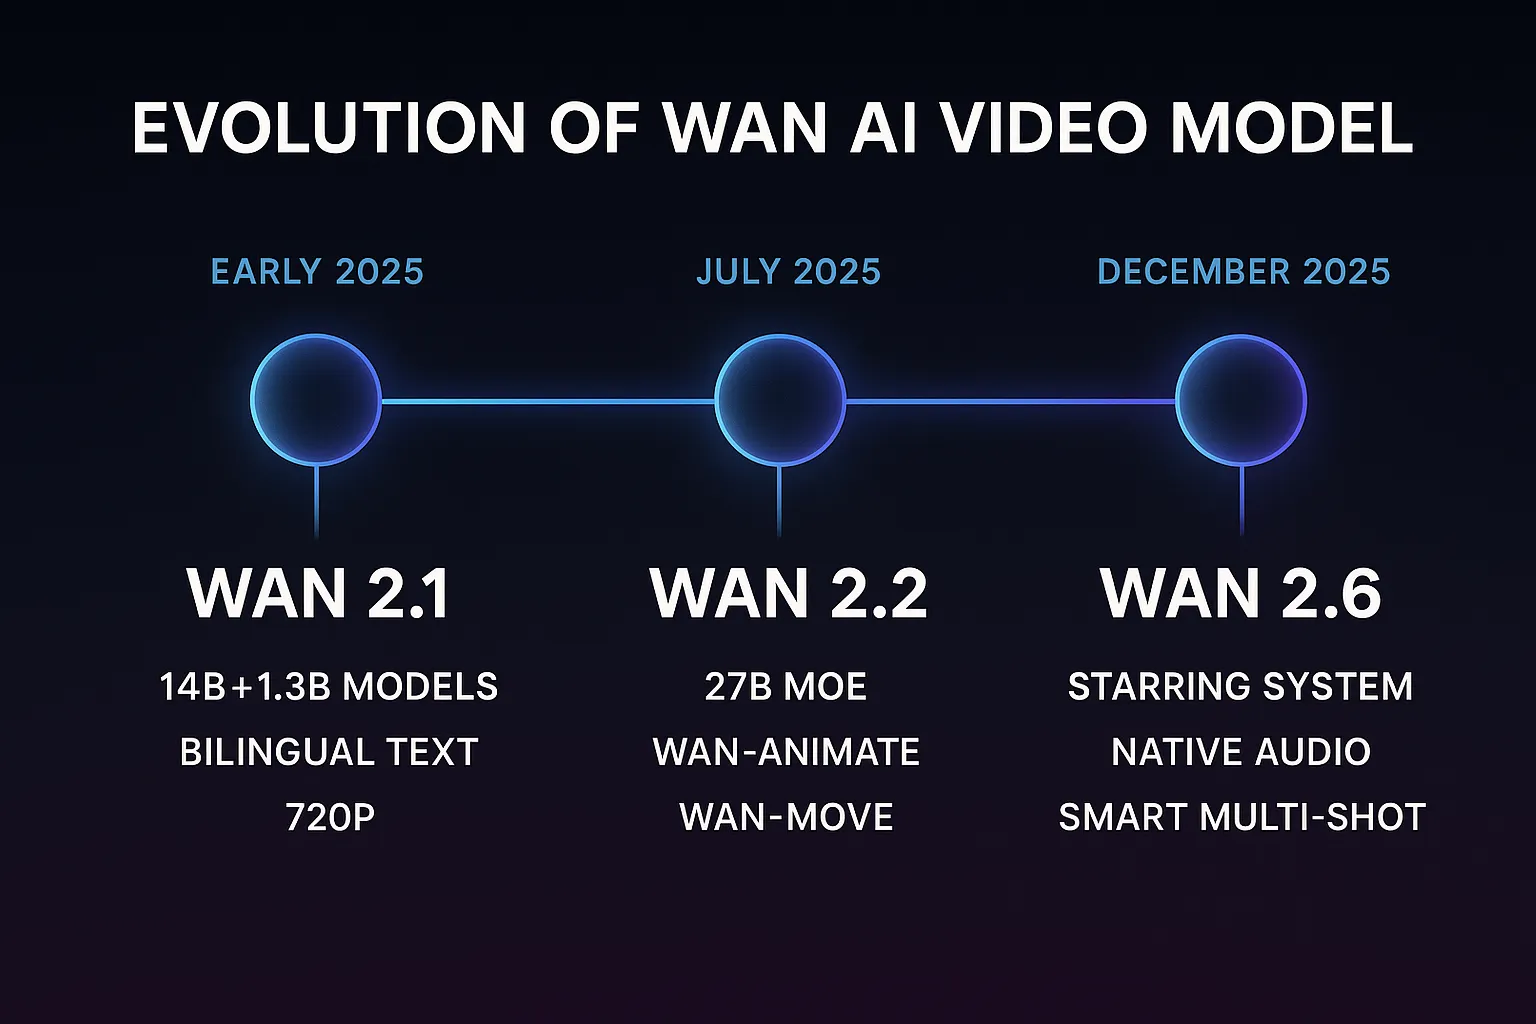
El nombre «Wan» (万) significa «diez mil» en chino y representa la ambición del modelo de abarcar la enorme diversidad del contenido visual. Desde su lanzamiento inicial a principios de 2025, Wan ha pasado por tres versiones principales, cada una con capacidades importantes: del texto a vídeo básico de la versión 2.1, pasando por la mezcla de expertos centrada en la eficiencia de la 2.2, hasta la narración multiplano de nivel narrativo de la 2.6.
Lo que hace especialmente atractivo el generador de vídeo Wan para creadores y desarrolladores es su enfoque de doble modelo. Un modelo ligero de 1.300 millones de parámetros funciona en GPU de consumo para prototipar rápido, mientras que el modelo completo de 14.000 millones de parámetros ofrece una calidad cinematográfica a la altura de los mejores servicios comerciales. Esta flexibilidad hace que Wan sea accesible tanto para creadores independientes que experimentan en un portátil como para estudios de producción con infraestructura en la nube. Si quieres dominar en la práctica la variante alojada de imagen a vídeo, tienes una guía completa de WAN 2.7 Spicy.
Evolución de versiones: de Wan 2.1 a Wan 2.6
Wan 2.1: la base (principios de 2025)
Wan 2.1 estableció la base arquitectónica sobre la que se construyen todas las versiones posteriores. Se lanzó con dos tamaños de modelo: el modelo completo de 14B parámetros para la máxima calidad y un modelo destilado de 1,3B para una inferencia más rápida en hardware de consumo. Las capacidades clave en el lanzamiento eran:
- Texto a vídeo (T2V): genera clips de vídeo en 480p o 720p de hasta 5 segundos a partir de prompts en lenguaje natural
- Imagen a vídeo (I2V): anima una imagen estática con movimiento fluido conservando la composición original
- Prompts bilingües: soporte nativo para texto en inglés y en chino mediante el codificador umT5
- Altas puntuaciones estéticas: primer modelo open source en superar a todos los competidores comerciales en el benchmark compuesto de VBench
Ya en la versión 2.1, el generador de vídeo Wan AI mostraba un movimiento notablemente coherente, un renderizado preciso de texto dentro de los fotogramas y una gran fidelidad al prompt, áreas en las que muchos modelos open source anteriores tenían dificultades.
Wan 2.2: el salto en eficiencia (julio de 2025)
La versión 2.2 introdujo la arquitectura Mixture-of-Experts (MoE) de 27.000 millones de parámetros, un gran salto en eficiencia de inferencia. En lugar de activar todos los parámetros en cada fotograma, el diseño MoE dirige cada cálculo a redes expertas especializadas, lo que reduce mucho el tiempo de generación y mejora la calidad del resultado.
Nuevos módulos introducidos en Wan 2.2:
- Wan-Animate: animación de personajes a partir de una sola imagen de referencia, manteniendo la identidad de forma coherente entre fotogramas
- Wan-Move: transferencia de movimiento que aplica el movimiento de un vídeo a otro sujeto
- Pipeline I2V mejorado: transiciones más suaves, mejor coherencia temporal y soporte para clips más largos
- Inferencia optimizada: el modelo MoE de 27B activa solo una fracción de sus parámetros por token y logra una calidad superior a la del modelo denso de 14B a una velocidad similar
La versión 2.2 del generador de vídeo Wan AI consolidó su posición como el modelo de vídeo open source más capaz disponible, con benchmarks de la comunidad que confirmaron mejoras de calidad en realismo del movimiento, precisión del color y fidelidad al prompt.
Wan 2.6: la era narrativa (diciembre de 2025)
Wan 2.6 pasó de la generación de clips sueltos a la narración coherente en vídeo. Tres funciones principales definen esta versión:
- Starring System (R2V, de referencia a vídeo): aporta una imagen de referencia del personaje y Wan mantiene su aspecto en varios clips generados de forma independiente. Esto permite conservar la identidad del protagonista a lo largo de toda una narración en vídeo.
- Audio nativo (V2A, de vídeo a audio): generación de audio integrada y sincronizada con el contenido visual. El modelo produce sonido ambiente, sincronización labial ajustada al diálogo y efectos de sonido directamente a partir de los fotogramas, sin necesidad de un pipeline de audio externo.
- Smart Multi-Shot: descompone automáticamente un prompt narrativo largo en planos individuales con las transiciones, ángulos de cámara y ritmo adecuados. Esto convierte el generador de vídeo Wan de una herramienta de clips en un motor de cortometrajes.
Wan 2.6 también mejoró la calidad de generación base: el modelo de 14B admite ahora hasta resolución 1080p y clips de 10 segundos en una sola pasada, y la concatenación multiplano permite narraciones más largas.
Arquitectura técnica
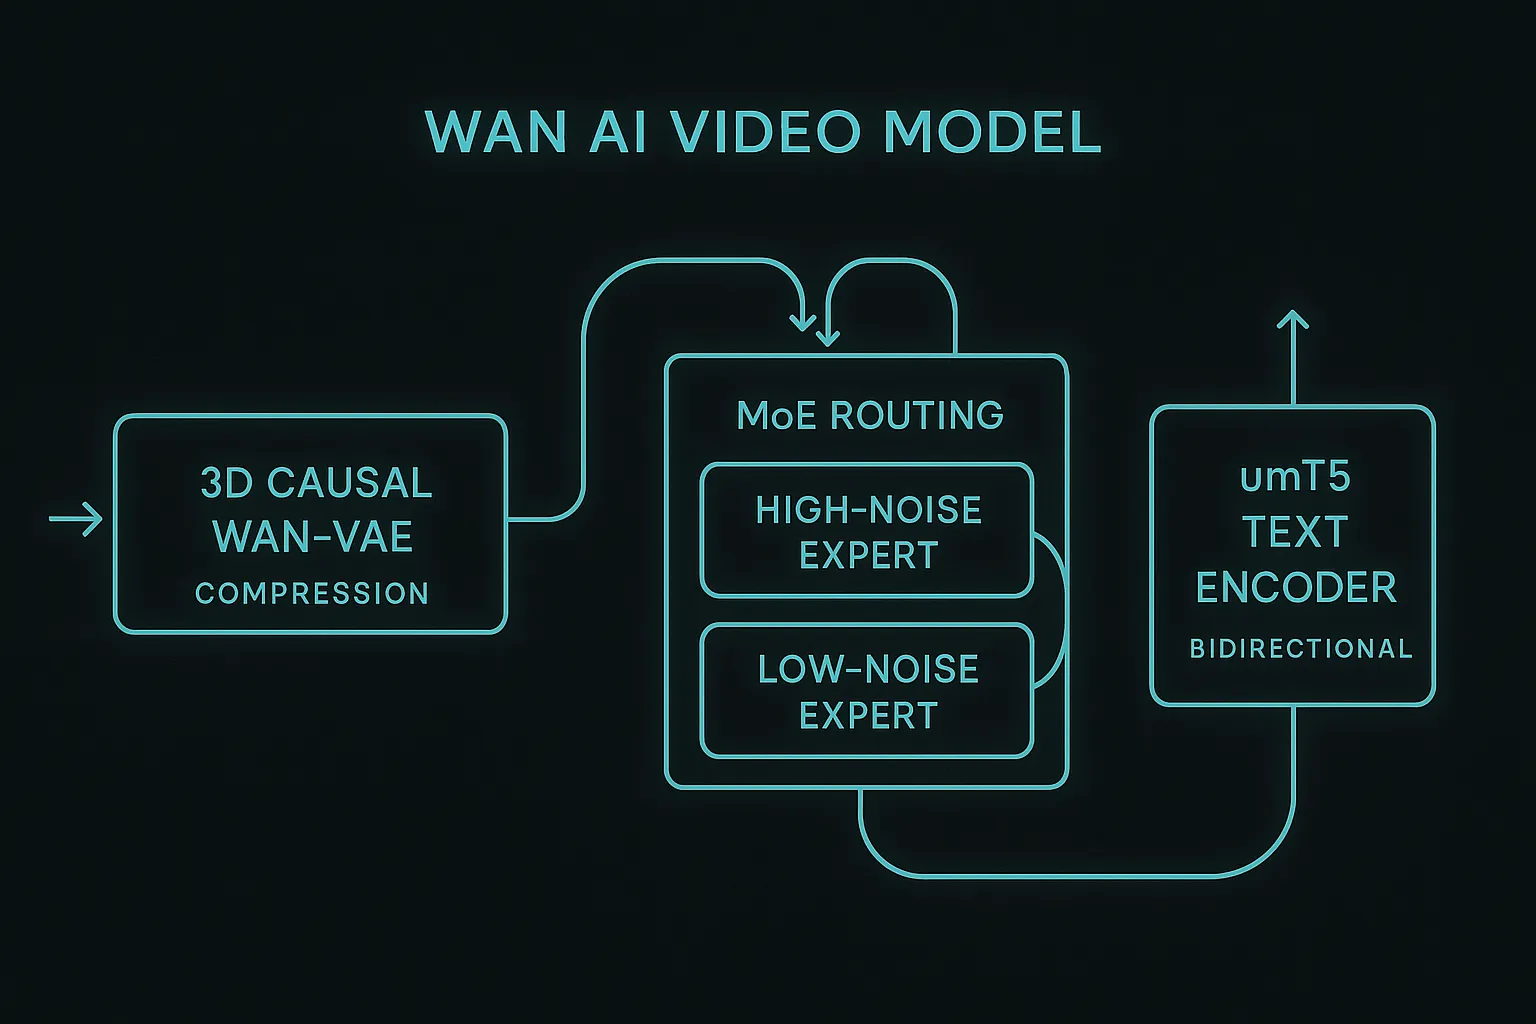
El generador de vídeo Wan AI se basa en tres innovaciones principales que lo diferencian de los modelos de la competencia. Entender estos componentes ayuda a explicar por qué Wan logra mejores puntuaciones en los benchmarks sin perder velocidades de inferencia prácticas.
Wan-VAE causal 3D
En el corazón del pipeline de Wan hay un autoencoder variacional causal 3D propio (Wan-VAE) que comprime los fotogramas de vídeo en bruto en un espacio latente compacto. A diferencia de los VAE de imagen estándar, que procesan los fotogramas de forma independiente, Wan-VAE opera en tres dimensiones —alto, ancho y tiempo— y captura las relaciones temporales directamente en la representación latente.
La innovación clave es el Feature Cache Mechanism (mecanismo de caché de características): en lugar de recalcular las características espaciales en cada paso temporal, el codificador almacena en caché los mapas de características intermedios y los reutiliza en fotogramas adyacentes. Esto reduce el cálculo redundante aproximadamente un 60 % durante la codificación, lo que hace que Wan-VAE sea unas 2,5 veces más rápido que el VAE de HunyuanVideo y produzca reconstrucciones de mayor fidelidad.
Enrutamiento Mixture-of-Experts (MoE)
A partir de Wan 2.2, la red troncal de difusión usa una arquitectura Mixture-of-Experts que dirige cada paso de eliminación de ruido a subredes especializadas:
- Experto de alto ruido: se activa en los primeros pasos de eliminación de ruido, cuando el modelo establece la disposición global, la composición y las trayectorias de movimiento a gran escala
- Experto de bajo ruido: entra en juego en los pasos posteriores para refinar texturas finas, detalles de iluminación, expresiones faciales y movimiento a nivel subpíxel
Este enrutamiento hace que el modelo de 27B active solo unos 8–10B parámetros por paso y ofrezca una calidad superior a la del modelo denso de 14B con un coste de inferencia comparable. El enfoque MoE también permite escalar la calidad de forma más gradual: puedes cambiar velocidad por calidad ajustando el número de pasos de eliminación de ruido sin las caídas bruscas de calidad habituales en los modelos densos.
Codificador de texto umT5
Wan usa un codificador de texto T5 multilingüe unificado (umT5) en lugar de los codificadores basados en CLIP habituales en los generadores de imágenes. Ventajas clave:
- Atención bidireccional: a diferencia del procesamiento unidireccional de CLIP, umT5 entiende el contexto en ambas direcciones y produce representaciones semánticas más ricas de los prompts complejos
- Soporte bilingüe nativo: entrenado conjuntamente con texto en inglés y en chino, permite escribir prompts con naturalidad en cualquiera de los dos idiomas sin artefactos de traducción
- Manejo de contexto largo: admite prompts de hasta 512 tokens, lo que permite descripciones detalladas de escenas, interacciones entre varios personajes e indicaciones concretas de cámara en un solo prompt
Rendimiento en benchmarks
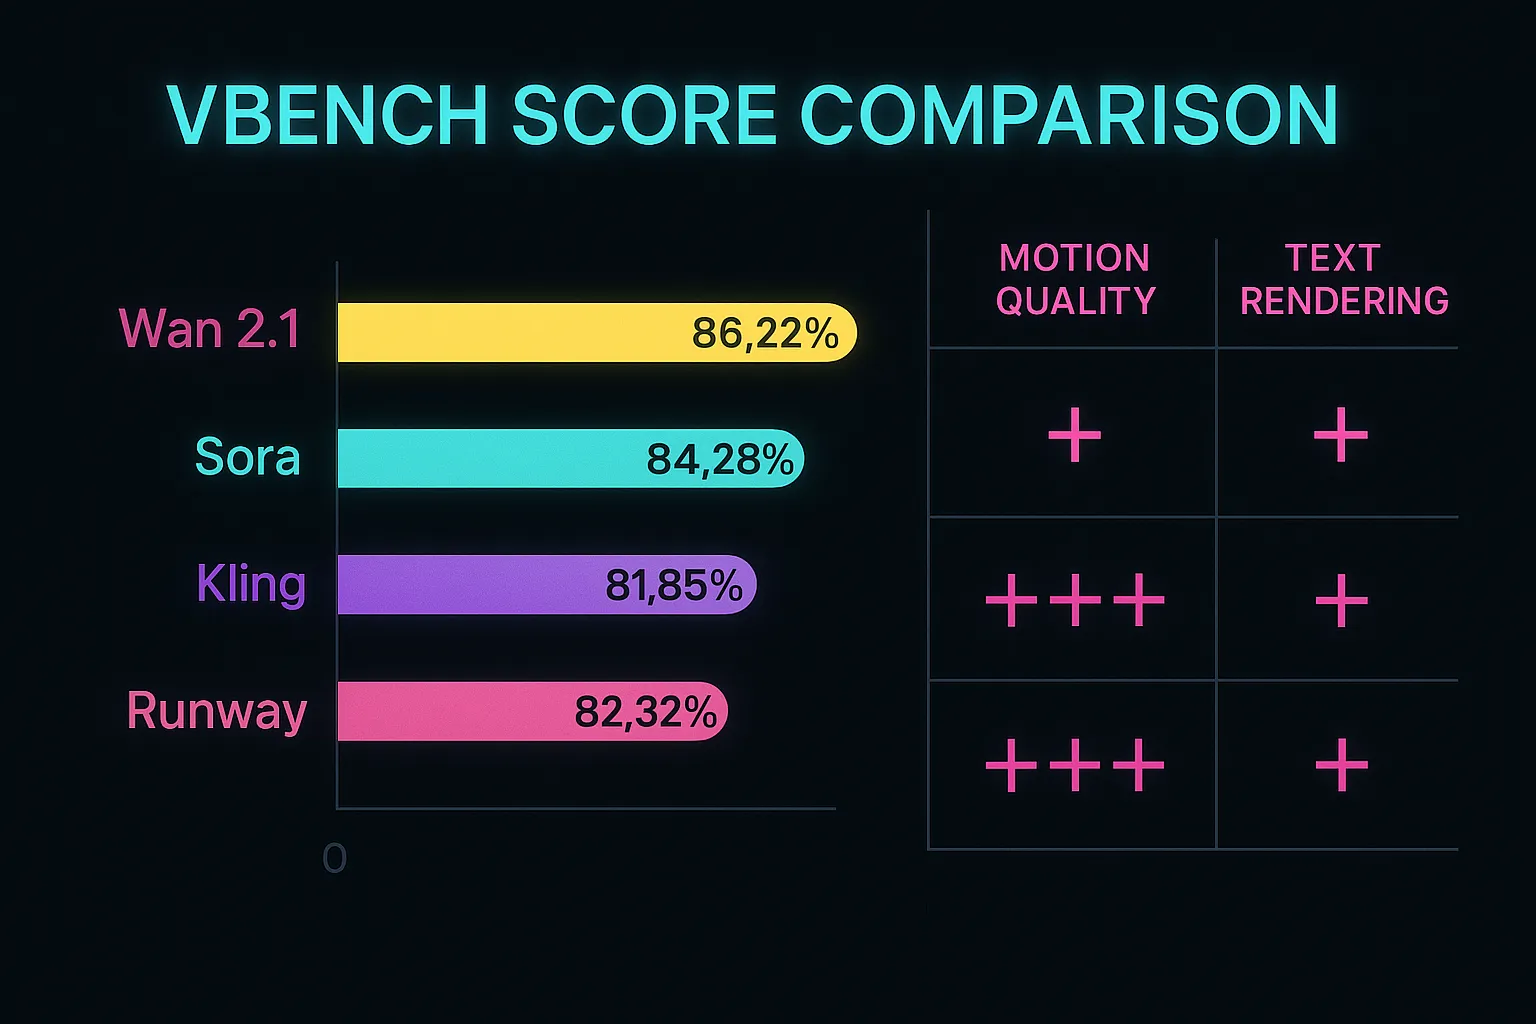
El generador de vídeo Wan AI tiene la puntuación compuesta más alta en VBench, el benchmark más utilizado para la generación de vídeo con IA. Así se comparan los principales modelos:
| Modelo | Puntuación VBench | Resolución | Duración máxima | Renderizado de texto | Open source |
|---|---|---|---|---|---|
| Wan 2.2 (14B) | 86,22 % | 720p–1080p | 10 s | Fuerte | Sí (Apache 2.0) |
| Sora (OpenAI) | 84,28 % | 1080p | 20 s | Moderado | No |
| Runway Gen-3 | 82,32 % | 1080p | 10 s | Débil | No |
| Kling 1.5 (Kuaishou) | 81,85 % | 1080p | 10 s | Moderado | No |
| Pika 1.5 | 80,61 % | 720p | 4 s | Débil | No |
Más allá de la puntuación compuesta, el generador de vídeo Wan destaca en varias categorías concretas:
- Calidad del movimiento: la coherencia temporal de Wan supera a todos los modelos probados, con menos artefactos en movimientos rápidos de cámara y en el movimiento complejo del sujeto
- Renderizado de texto en vídeo: Wan es el primer modelo open source que renderiza de forma fiable texto legible en carteles, pantallas y objetos dentro del vídeo generado, una capacidad que antes estaba limitada a Sora
- Fidelidad al prompt: el codificador umT5 ofrece una alineación medible y mejor entre los prompts complejos con varios elementos y el resultado generado
- Calidad estética: colorimetría profesional e iluminación natural que rivalizan con las imágenes de cámaras físicas
Sin embargo, la ventaja más importante puede ser la disponibilidad. Mientras que Sora requiere una suscripción a ChatGPT Pro (200 $/mes) con límites de generación y Runway cobra por segundo generado, el modelo Wan completo puede alojarse por cuenta propia con un coste marginal cero por generación tras la inversión inicial en hardware.
Ejecutar Wan: en local o en la nube
Instalación local (edición rápida 1.3B)
Ejecutar el generador de vídeo Wan AI en local es ideal para prototipar rápido, iterar con los prompts y generar contenido sin coste por clip. El modelo de 1,3B está optimizado para hardware de consumo:
Requisitos mínimos:
- GPU: NVIDIA RTX 4090 (24 GB de VRAM) o equivalente
- RAM: 32 GB de memoria del sistema
- Almacenamiento: ~15 GB para los pesos del modelo
- Sistema operativo: Linux (recomendado) o Windows con WSL2
Qué esperar:
- Resolución: 480p (832 x 480)
- Tiempo de generación: ~4 minutos para un clip de 5 segundos
- Calidad: buena para storyboards, borradores para redes sociales y validación de conceptos
- Coste: gratis tras la inversión en hardware
Inicio rápido:
git clone https://github.com/Wan-Video/Wan2.1
cd Wan2.1
pip install -r requirements.txt

# Text-to-Video generation
python generate.py \
  --task t2v-1.3B \
  --size 832*480 \
  --prompt "A cat walking across a sunlit windowsill, dust particles floating in golden light"
El modelo de 1,3B es el mejor punto de entrada para los creadores que quieren experimentar con el generador de vídeo Wan sin costes en la nube. La calidad es realmente utilizable para contenido en redes sociales, sobre todo tras un posprocesado básico.
API en la nube (edición Pro 14B)
Para obtener resultados con calidad de producción, el modelo completo de 14B ofrece resultados cinematográficos a través de proveedores de API en la nube:
Proveedores recomendados:
- DashScope (Alibaba Cloud): API oficial con las versiones más recientes del modelo, 0,10–0,15 $ por clip de 5 segundos en 720p
- SiliconFlow: alojamiento de terceros con precios competitivos, 0,12–0,29 $ por clip según resolución y duración
- Replicate: precio por segundo, fácil integración con flujos de trabajo existentes
Qué esperar:
- Resolución: de 720p a 1080p
- Tiempo de generación: 30–90 segundos según el proveedor y la cola
- Calidad: cinematográfica, apta para contenido comercial, anuncios y producción de vídeo profesional
- Coste: 0,10–0,29 $ por clip
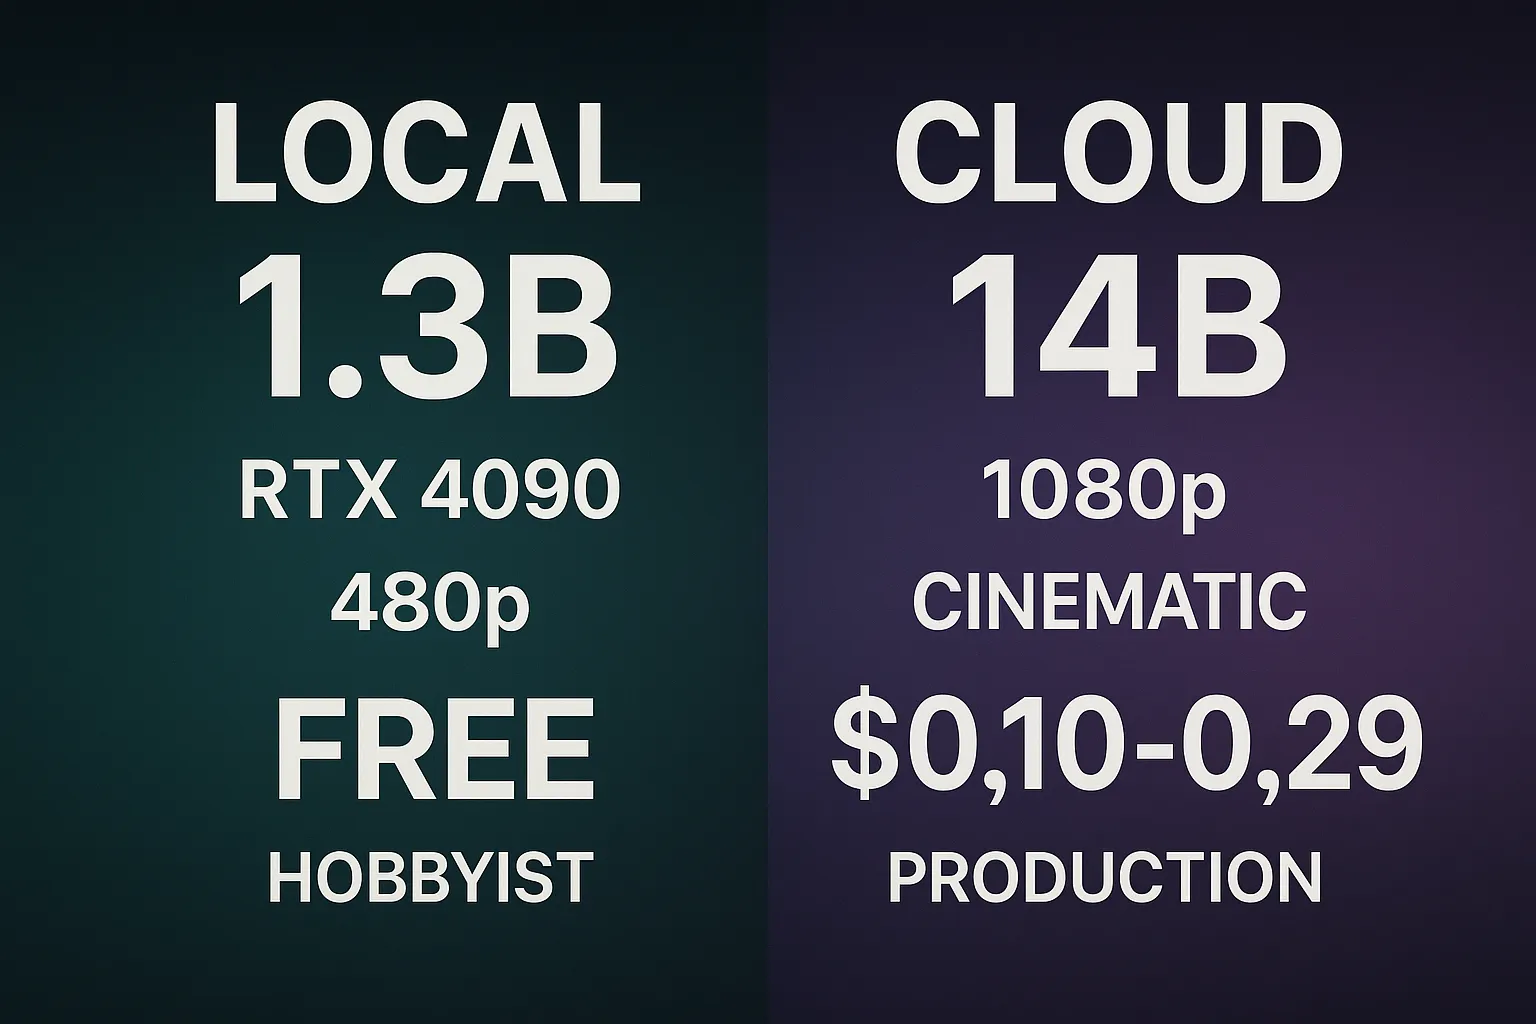
Para la mayoría de los creadores, lo mejor es un enfoque híbrido: prototipar con el modelo local de 1,3B y generar el resultado final con la API de 14B en la nube. Este flujo de trabajo minimiza los costes en la nube y mantiene la velocidad de iteración que necesita el trabajo creativo.
Precios y licencia
El generador de vídeo Wan AI se publica bajo la licencia Apache 2.0, una de las licencias open source más permisivas que existen. En la práctica, esto significa:
- Uso comercial gratuito: puedes vender contenido generado con Wan sin royalties ni obligación de atribución
- Modificación libre: haz fine-tuning del modelo con tus propios datos, modifica la arquitectura y distribuye tus cambios
- Sin seguimiento de uso: Wan alojado por tu cuenta no envía telemetría ni datos de uso a Alibaba
- Concesión de patentes: la licencia Apache 2.0 incluye una concesión explícita de patentes que protege a los usuarios frente a reclamaciones de patentes sobre la tecnología cubierta
Desglose de costes
| Método de despliegue | Coste inicial | Coste por clip | Ideal para |
|---|---|---|---|
| Local 1.3B (RTX 4090) | 1.600–2.000 $ (GPU) | ~0,01 $ de electricidad | Prototipos, contenido social en gran volumen |
| Local 14B (A100 80GB) | 10.000–15.000 $ (GPU) | ~0,03 $ de electricidad | Estudios con carga de trabajo constante |
| API en la nube (DashScope) | 0 $ | 0,10–0,15 $/clip | Calidad de producción bajo demanda |
| API en la nube (SiliconFlow) | 0 $ | 0,12–0,29 $/clip | Uso flexible, sin compromiso |
| Alquiler de GPU en la nube (RunPod) | 0 $ | 1,50–3,00 $/hora | Control total, uso intermitente |
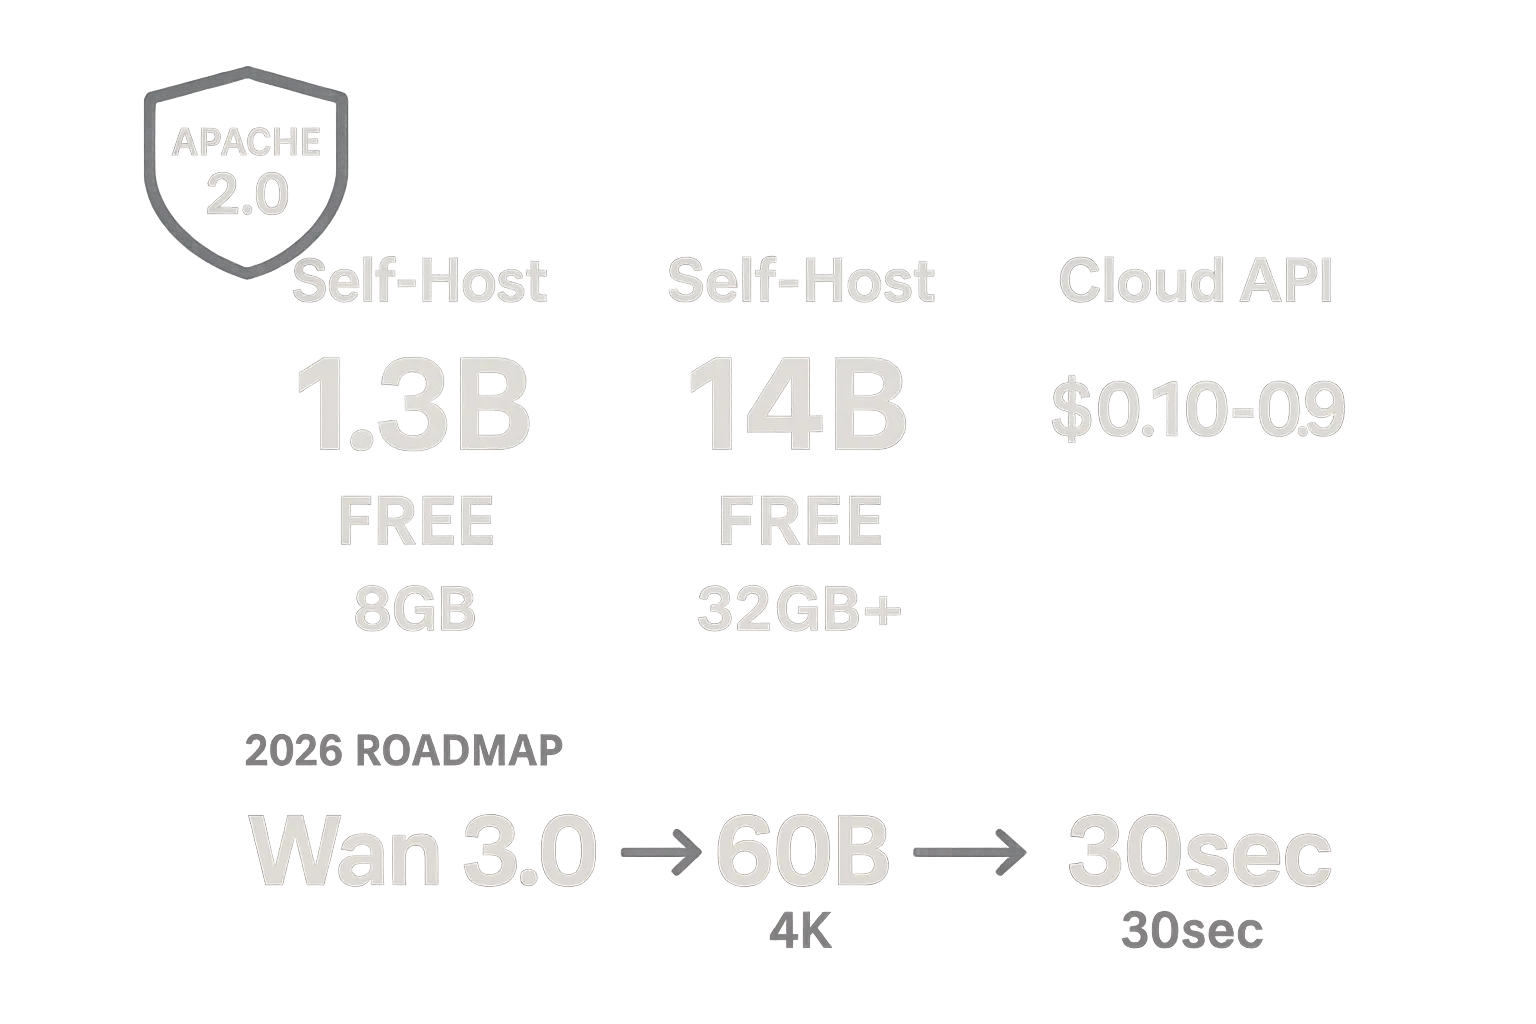
Comparado con las alternativas de código cerrado —Sora requiere una suscripción a ChatGPT Pro de 200 $/mes, Runway cobra 0,25–0,50 $ por segundo de vídeo y Kling empieza en 0,30 $ por clip—, el generador de vídeo Wan AI ofrece el camino más rentable hacia vídeo con IA de alta calidad a cualquier volumen.
Hoja de ruta para 2026
Tongyi Lab, de Alibaba, ha anunciado varios desarrollos previstos a lo largo de 2026:
- Wan 3.0 (60B parámetros): un modelo mucho más grande orientado a resolución 4K y generación continua de 30 segundos en una sola pasada, previsto para mediados de 2026
- Soporte 1440p / 4K: salida nativa en ultraalta resolución para flujos de trabajo de televisión y cine
- Generación en tiempo real: optimizaciones orientadas a tasas de fotogramas interactivas para aplicaciones en directo
- Multiplano ampliado: generación automatizada de narraciones de 2–5 minutos con personajes, escenarios y ritmo coherentes
- Ecosistema de fine-tuning comunitario: herramientas y datasets oficiales para adaptar el modelo a dominios concretos (anuncios de producto, estilos de animación, visualización arquitectónica)
Al ser open source, la comunidad también contribuye activamente con mejoras. Proyectos de optimización de terceros ya han logrado una inferencia un 30–40 % más rápida mediante cuantización y kernels CUDA personalizados, y los adaptadores LoRA de fine-tuning se multiplican para estilos y temas especializados.
Prueba los modelos Wan en ZenCreator, sin instalar nada
¿No quieres lidiar con requisitos de GPU ni instalaciones locales? ZenCreator ejecuta los modelos Wan en la nube para que empieces a generar al instante: sin hardware, sin claves de API y sin configuración.
Imagen a vídeo con Wan
ZenCreator ofrece cuatro modelos de vídeo Wan para la generación de imagen a vídeo:
- WAN 2.2 + LoRAs: Wan con soporte para LoRA para mantener un estilo y unos personajes coherentes. Admite fotograma inicial y contenido sin restricciones.
- WAN 2.2: el modelo más flexible para movimiento creativo. Admite fotograma inicial, fotograma final y contenido sin restricciones.
- Wan 2.5 + Audio: movimiento guiado por audio con sincronización labial y ajuste al ritmo. Admite fotograma inicial y entrada de audio.
- Wan 2.6 + Audio: la última versión, con generación guiada por audio, sincronización labial y control del ritmo mejorados. Admite fotograma inicial y entrada de audio.
Todos los modelos admiten la generación de contenido NSFW: sin filtros ni restricciones en tu producción creativa.
Texto a imagen con Wan
ZenCreator también incluye un modelo Wan de texto a imagen optimizado para estilos creativos, con soporte para contenido sin restricciones y resoluciones de hasta 1K. Úsalo para generar los fotogramas iniciales de tu pipeline de vídeo: crea una imagen a partir de un prompt y anímala después con cualquiera de los modelos de vídeo Wan anteriores.
Tanto si estás prototipando ideas como creando contenido para redes sociales o montando un pipeline de producción completo, ZenCreator te da acceso a los últimos modelos Wan con una interfaz sencilla en el navegador y planes de créditos asequibles desde 19,99 $.
Preguntas frecuentes
¿Qué es el generador de vídeo Wan AI?
El generador de vídeo Wan AI es un modelo open source de generación de vídeo desarrollado por Tongyi Lab, de Alibaba. Convierte prompts de texto o imágenes estáticas en clips de vídeo de alta calidad mediante una arquitectura de difusión con un VAE causal 3D y un diseño Mixture-of-Experts. Está disponible bajo licencia Apache 2.0, por lo que es gratuito tanto para uso personal como comercial.
¿El generador de vídeo Wan AI es gratis?
Sí, el generador de vídeo Wan AI es completamente gratuito. Los pesos del modelo, el código de entrenamiento y los scripts de inferencia se publican bajo licencia Apache 2.0, sin tarifas de uso ni royalties. Los únicos costes son tus propios recursos de cómputo: una GPU local o las tarifas de una API en la nube, que empiezan en aproximadamente 0,10 $ por clip.
¿Cómo se ejecuta el generador de vídeo Wan AI en local?
Para ejecutar el generador de vídeo Wan AI en local necesitas una GPU NVIDIA con al menos 24 GB de VRAM (como una RTX 4090) para el modelo de 1,3B. Clona el repositorio oficial de GitHub, instala las dependencias de Python y ejecuta el script de generación con tu prompt. El modelo de 1,3B genera un clip de 5 segundos en 480p en unos 4 minutos con hardware de consumo.
¿Qué diferencia hay entre Wan 2.1, 2.2 y 2.6?
Wan 2.1 introdujo las capacidades básicas de texto a vídeo e imagen a vídeo con modelos de 14B y 1,3B. Wan 2.2 añadió una arquitectura Mixture-of-Experts de 27B para mejorar la eficiencia, además de módulos de animación de personajes y transferencia de movimiento. Wan 2.6 trajo funciones de narración, como la identidad coherente del personaje entre planos, la generación de audio nativa y la descomposición automática en varios planos.
¿Wan AI es open source?
Sí, el generador de vídeo Wan AI es totalmente open source bajo licencia Apache 2.0. Esto incluye todos los pesos del modelo (variantes de 1,3B, 14B y 27B MoE), el código de entrenamiento, los scripts de inferencia y la documentación. Puedes modificar, hacer fine-tuning y desplegar el modelo libremente para cualquier fin, incluidas aplicaciones comerciales, sin obligación de atribución.
¿Cómo se compara Wan con Sora?
El generador de vídeo Wan AI puntúa más alto que Sora en el benchmark VBench (86,22 % frente a 84,28 %), con ventajas especiales en calidad del movimiento y renderizado de texto. Sora ofrece una duración máxima de clip mayor (20 segundos frente a 10) y una resolución base ligeramente superior. La mayor diferencia práctica es el acceso: Wan es gratuito y open source, mientras que Sora requiere una suscripción a ChatGPT Pro de 200 $/mes con límites de generación.
¿Wan AI puede generar vídeo a partir de imágenes?
Sí, la generación de imagen a vídeo es una de las capacidades principales de Wan AI. Aportas una imagen estática como entrada y el modelo la anima en un clip de vídeo fluido, conservando la composición, los colores y la identidad del sujeto de la imagen original. A partir de Wan 2.2, el módulo Wan-Animate también permite animar personajes concretos a partir de una sola foto de referencia.